この記事の要点
日本語の文の判定まで試すなら、測ったモデルの中では nimble と tev1 の大きいほうが候補になる。日本語の形での正答数は同じで、小さな問題セットでは優劣を付けられなかった。皮肉を込めたレビューの問題は、どのモデルも高い確信度のまま読み違えたので、確信度が低い回答だけを人が確認するやり方では、拾えない誤答が残る。
質問を一度のリクエストにまとめても、同じ PC の中で測った範囲では往復時間は縮まなかった。まとめ方で答えが変わるかは比べていない。同時に送った分はエラーにならずに順番待ちになり、1件ごとの待ち時間が伸びた。
tev1 の小さいほうは軽くて速い反面、日本語で「はい/いいえ」の2択を選ばせる問題で外れが目立ち、確信度の低い回答が多いぶん、人が確認する件数が増える。tev1 の大きいほうは、1リクエストの往復時間が RTX 5080 では nimble と同程度だった。RTX 5060 Ti では nimble より短かったが、サーバーの設定が違う条件での比較なので参考値にとどまる。
判断モデルを Ollama で呼ぶと何が返ってくるか
Ollama は2026年9月29日のブログで、0.35 以降で Jev 型の判断モデルに対応したと発表した。最初に使えるのは Bespoke Labs の nimble (9B) と、Together AI の tev1 (4B と 0.8B) の3つ。Ollama のクラウドで動く判断モデルも今後出すとしているが、発表の時点では予告にとどまる。測定に使った 0.40.0 のリリースノートには clef と clef-flash も判断モデルとして載っている。Ollama のモデルページによると、どちらも Cloudflare のモデルで、大きさは clef が 27B、clef-flash が 9B。この2つは当記事では測っていない。
この記事で使う Ollama の API は、文章を生成させるのではなく、あらかじめ決めた選択肢ごとの確率を返す。モデルそのものに文章を書く力がないという意味ではない。判断モデルの仕組みと、Jev 本家の料金や日本語で使う前の制約については「Jevとは|文章を書かない判断モデルの仕組み・料金と、日本語で使う前に見る制約」で詳しく扱っている。ここでは Ollama で手元に置いたときの呼び方と、返ってくる値の読み方に絞る。
リクエストの形
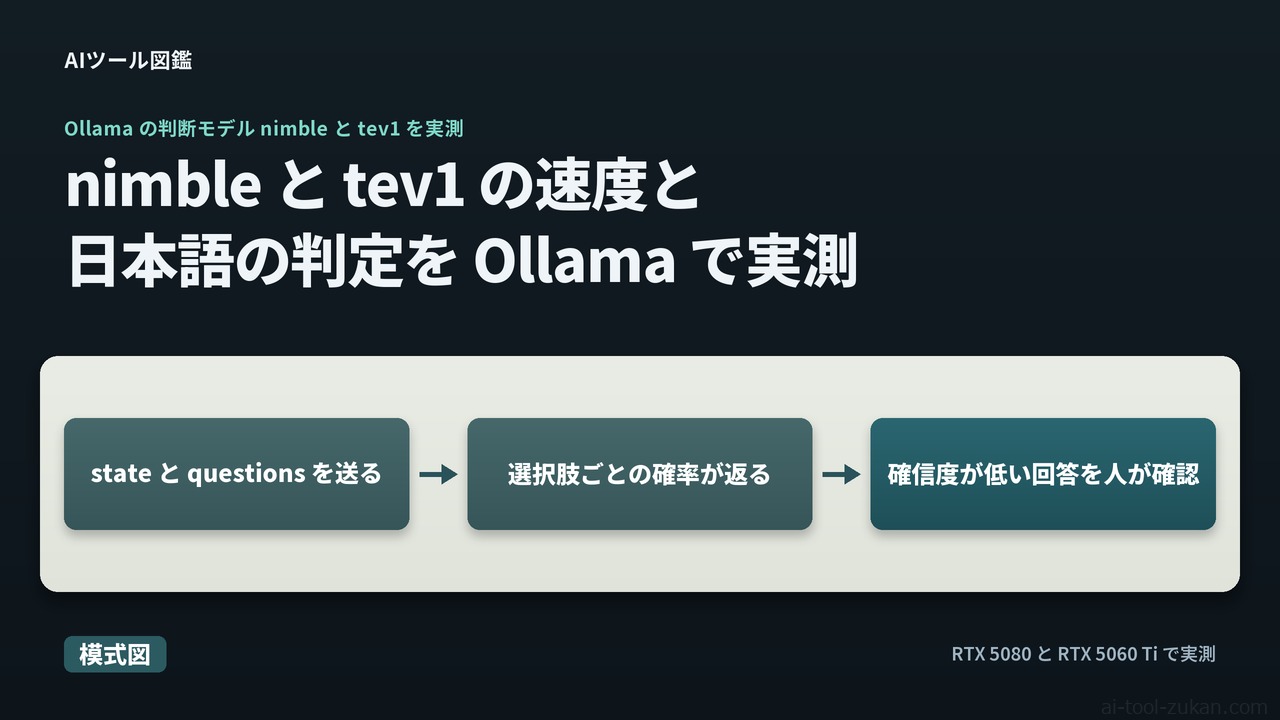
Ollama は判断モデルを POST /v1/systemone で受け付ける。リクエストに必ず入れるのは model、state (判定させたい文や情報)、questions (名前を付けた質問) の3つで、ほかにモデルを読み込んだままにしておく時間を決める keep_alive を任意で付けられる。画像を渡す images もあるが、画像を読める clef と clef-flash 向けで、当記事で測った nimble と tev1 には使えない。1回のリクエストに載せられる質問は 1〜64 個。
質問の型は3つある。選択肢から1つを選ぶ choice、はい/いいえで答える noul、段階を決めた基準で採点する score だ。choice の選択肢は、Ollama の判断モデルのガイドと nimble・tev1 のモデルページでは 2〜26 個とされ、測定に使った 0.40.0 の実装も 26 個を超える選択肢を受け付けない。API リファレンスのスキーマには最大 255 個とあるが、上限はモデルによるという注記が付いている。tev1 は 2〜24 個で学習されているため、その範囲に収めるようモデルページが求めている。score は、低い順に並べた段階に0から番号を振り、その番号を確率で重み付けして平均した値を返すので、整数の段階が1つ返ってくるわけではない (score 型は当記事では測っていない)。画像を含まないリクエストは 64 KiB に収める必要があり、ストリーミングと、温度などの生成の制御には対応していない。
例を試す前に、Ollama を起動して ollama pull nimble:9b でモデルを取得しておく。次のリクエスト例は、日本語の問い合わせ文を3つの窓口へ振り分ける choice の質問を1つだけ載せた最小の形。リクエストの形は Ollama の API ドキュメントの例と同じで、中身は当記事の日本語の問題セットから1問を使った。質問の名前 (team) は自由に付けられる。例は bash などのシェル向けの書き方になっている。Windows の PowerShell では curl が別のコマンドの別名になっている場合があり、行末の \ で行をつなぐ書き方も使えない。コマンドプロンプトでは単一引用符が引用符として扱われない。どちらでも curl.exe と書いたうえで、引用符と改行をそのシェルの書き方に直す。
curl http://localhost:11434/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
  "model": "nimble:9b",
  "state": "同じ注文で二回引き落とされています。片方を取り消してください。",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "この問い合わせはどの窓口が担当すべきですか?",
      "criteria": {
        "1": "支払い・返金",
        "2": "配送 (遅れ・破損・紛失)",
        "3": "アカウント・ログイン"
      }
    }
  }
}'
応答の読み方
同じ文と質問で nimble:9b から取得した応答を、2026年10月7日に RTX 5080 で記録した。確率と確信度は小数第3位で丸めてあり、キーの意味は Ollama の API ドキュメントの定義に従う。記録したときの質問の名前は q で、掲載にあたって team に置き換えている。
{
  "model": "nimble:9b",
  "answers": {
    "team": {
      "type": "choice",
      "choice": "1",
      "probabilities": {"1": 0.980, "2": 0.006, "3": 0.014},
      "confidence": 0.901
    }
  },
  "usage": {"input_tokens": 213, "output_tokens": 1}
}
応答は質問ごとに、選ばれた選択肢 (choice)、選択肢ごとの確率 (probabilities、合計が1)、確信度 (confidence) を返す。確信度は確率の分布がどれだけ1か所に偏っているかを表す値で、1 − エントロピー ÷ ln(選択肢の数) で計算される。確率が均等に割れると0、1つに集中すると1に近づく。選ばれた選択肢の確率と確信度は別の量で、記録した応答でも「1」の確率は 0.980、確信度は 0.901 と値が違う。noul の答えは「はい」の確率の数値だけで、確信度は付かない。確率は渡した選択肢の中だけで割り振った値なので、ふさわしい答えが選択肢に無くても合計は1になり、確信度が高く出ることもある。どれにも当てはまらない文が届く用途では、「該当なし」の選択肢を用意しておくよう nimble のモデルページも勧めている。
3つのモデルの公表値
3つのモデルの作り手と大きさ、Ollama のモデルページに載っている正答率、言語についての記載を「モデルの公表値の表」にまとめた。正答率は Ollama のモデルページの「On Ollama」の欄に載っている値で、誰が評価したかはページに明記がない。当サイトが測った値でもない。
| モデル | 作り手 | 大きさ | 13 の評価セットの平均正答率 (モデルページ「On Ollama」の掲載値) | 言語についての記載 |
|---|---|---|---|---|
| nimble:9b | Bespoke Labs | 9B (Qwen3.5-9B をもとに調整) | 75.7% | Hugging Face のモデルカードで英語と記載 |
| tev1:4b | Together AI | 4B | 73.3% | 英語以外の言語は十分に試していないとモデルページに記載 |
| tev1:0.8b | Together AI | 0.8B | 63.5% | 英語以外の言語は十分に試していないとモデルページに記載 |
正答率の母体は、Bespoke Labs が評価用に選んだ、人がラベルを付けた既存の公開データセットから切り出した 13 の評価セット (判断の数は合計 3,880)。nimble のモデルページには、Ollama で動かした結果とは別に、Bespoke Labs が元の公開版で測った結果も載っていて、13 の評価セットの平均は 74.8% (Bespoke Labs の公開資料では、判断1件ずつで数えた平均が 75.9%)、型ごとの平均は choice が 81.6%、noul が 80.2%、score が 54.6% になっている。型ごとの値は Bespoke Labs が元の公開版で測ったもので、表の 75.7% を型ごとに分けた値ではない。nimble のライセンスは Apache 2.0 で、プロンプトは 8,192 トークンに収める必要がある。tev1 は Together AI が実験的なモデルとして出していて、Together AI のモデルカードには、調整した重みのライセンスはまだ確定していないとある。商用で使うなら、モデルカードと Ollama の配布物のライセンス表示を確かめておく。tev1 のモデルページによるとコンテキストはおよそ 2,000 トークンで、入力を短く保つよう求めている (今回の起動で Ollama が割り当てたのは 2,304)。API の仕様では、質問を含めたプロンプトが読み込んだコンテキストを超えると 400 エラーが返り、入力は切り詰められない。日本語の文をどこまで判定できるかは公表値からは読み取れないので、後の節で手元の問題セットを使って確かめた。
測った環境と条件
測定は2026年10月7日に、Windows 11 の PC で行った。この測定は Ollama 0.40.0 で行い、NVIDIA ドライバは 610.47、CPU は Core i7-14700F で、OS が認識しているメモリは 95.8 GiB (速度や構成は記録していない)。装置は RTX 5080 (16GB)、RTX 5060 Ti (16GB)、GPU を使わない CPU のみの3通りで、それぞれ GPU を1枚だけ (または CPU のみ) が見える状態にしてサーバーを起動した。GPU では、nvidia-smi に出る GPU 名と使用量、サーバーのログに出る CUDA の装置名と GPU に確保したバッファを照らし合わせ、狙った GPU で動いていることを確かめた。Vulkan 経由で別の GPU が選ばれてしまった試行は、数値に含めていない。
モデルは nimble:9b、tev1:4b、tev1:0.8b で、どれも Ollama が配布している Q8_0。サーバーには、同時に読み込むモデルを1つにする (OLLAMA_MAX_LOADED_MODELS=1)、読み込んだモデルを 30 分保持する (OLLAMA_KEEP_ALIVE=30m) の2つを設定し、Vulkan を使わない設定 (OLLAMA_VULKAN=0) も加えた。ただし RTX 5060 Ti の tev1:0.8b と tev1:4b は、Vulkan を止める前のサーバーで測っている (ログで、CUDA 経由で RTX 5060 Ti に読み込まれたことは確かめている)。同時処理数は既定のまま (起動ログの表示は OLLAMA_NUM_PARALLEL=1) で、コンテキスト長もモデルの配布時の設定を使っている。呼び出しはすべて /v1/systemone で、この経路では Ollama 0.40.0 が内部で思考 (thinking) を無効にして採点する。数値を取ったサーバーは装置ごとに1回起動し (RTX 5060 Ti だけは tev1 用と nimble 用の2回)、1つのモデルの測定の途中で再起動したり、前の計算の記録を消したりはしていない。モデルを切り替えるときは読み込み直している。
0.40.0 の実装には、文と質問1つ、その選択肢だけでプロンプトを組む tev1 専用の形式と、質問の一式を並べる nimble と同じ形式がある。当記事で取得した tev1 (llama.cpp で動く配布版) にはどちらを使うかの設定が入っておらず、サーバーのログでも tev1 専用の形式は選ばれていなかった。そのため tev1 も、質問の一式を並べる形式で採点されている。Together AI のモデルカードが示す tev1 の入力は tev1 専用の形式に当たり、Ollama のモデルページの説明は今回の形式に当たる。Mac 向けの MLX 版の tev1 は、設定で tev1 専用の形式が指定されている (2026年10月8日にレジストリで確認)。当記事の tev1 の数値 (日本語の正誤、確信度、往復時間) は作り手の想定とは別の形式で採点したもので、専用の形式で測ると変わるかどうかは確かめていない。時間は同じ PC の中から HTTP で送って応答が返るまでの往復 (ループバック) で測っている。Ollama をアプリから呼ぶサーバーとして立てる手順そのものは「Ollama をローカル API サーバーにして社内アプリから LLM を呼ぶ」にまとめてある。
本記事の実測値は2026年10月7日に Ollama 0.40.0 で測ったもの。モデルの公表値と API の仕様は、2026年10月7日〜8日に各公式ページで確認した。
入力には、英語の問い合わせ風の定型文8種類を乱数でつなぎ、決めた語数で切った合成の文を、3つの長さで用意した (乱数の種は 20261001)。実際の問い合わせの多様さを代表するものではなく、12 語の文は途中で切れていることもある。
- 短い入力: 12 語。8種類の文を繰り返して 120 件
- 中くらいの入力: 150 語。120 件すべて違う文
- 長い入力: 400 語。120 件すべて違う文
API が返す入力トークン数 (usage.input_tokens) の中央値は、短い・中くらい・長いの順に tev1 が 435・727・1,255、nimble が 511・803・1,331。2つの質問はそれぞれ別のプロンプトとして採点され、この値はその2つぶんの合計なので、1つのプロンプトの長さではない。1回のリクエストには choice 1問と noul 1問を載せ、暖機の 20 件を捨てたあとの 100 件で中央値を取った。1台の PC で1日に測った結果である。
測っていない次元は次のとおり。ここに挙げた条件での速さや精度の優劣は、この記事の数値からは言えない。
- Mac での動作
- Q8_0 以外の量子化
- Ollama 0.40.0 以外の版
- 消費電力
- score 型の質問
- 長時間の連続稼働
- 同時処理数の設定を増やした場合
- TypeSafe SDK 経由の呼び出し
- ネットワーク越しの呼び出し (時間はすべて同じ PC の中で測った)
- 日本語の文を入力にしたときの往復時間
- CPU のみでの日本語の正誤
- tev1 専用の形式 (文と質問1つ、その選択肢だけのプロンプト) での採点
- 質問をまとめたときに、各質問の答えが変わるかどうか
- 同時 16 件を超える送信
- モデルを最初に読み込むまでの時間 (測定はすべて読み込み済みの状態で行った)
- clef・clef-flash など、nimble と tev1 以外の判断モデル
1リクエストの往復時間
短い入力の 120 件は8種類の文の繰り返しで、サーバーのログを見ると、前のリクエストと共通する部分の計算を使い回し、新しく計算する量がわずかな回が大半だった。中くらいと長い入力は 120 件すべて違う文で、毎回入力の大部分を計算し直していた。使い回しの仕組みの詳しいところは確かめていない。このため主な比較は中くらいの入力で行い、短い入力の値は同じ文が繰り返し届くときの値として読む。
「装置とモデルごとの往復時間の表」に、1リクエスト (choice と noul の2問) の往復時間の中央値を並べた。
| モデル | 装置 | 短い入力 | 中くらいの入力 | 長い入力 |
|---|---|---|---|---|
| tev1:0.8b | RTX 5080 | 93 ms | 103 ms | 134 ms |
| tev1:4b | RTX 5080 | 277 ms | 291 ms | 356 ms |
| nimble:9b | RTX 5080 | 202 ms | 270 ms | 365 ms |
| tev1:0.8b | RTX 5060 Ti | 161 ms | 175 ms | 224 ms |
| tev1:4b | RTX 5060 Ti | 263 ms | 318 ms | 414 ms |
| nimble:9b | RTX 5060 Ti | 309 ms | 435 ms | 497 ms |
| tev1:0.8b | CPU のみ | 204 ms | 1,051 ms | 1,799 ms |
| tev1:4b | CPU のみ | 746 ms | 5,731 ms | 9,449 ms |
| nimble:9b | CPU のみ | 1,195 ms | 9,741 ms | 測っていない |
CPU のみの nimble:9b の長い入力は測っていない。中くらいの入力でも1件 10 秒前後かかり、それより長い入力は測定に時間がかかるため見送った。
GPU の6通りについて、中くらいの入力の列を図にした。CPU のみは桁が違い、入れると GPU どうしの差が見えなくなるので図からは外し、装置とモデルごとの往復時間の表だけで示している。
中くらいの入力 (API の入力トークン数で 727〜803) で見ると、RTX 5080 では tev1:0.8b が 103 ms、nimble:9b が 270 ms、tev1:4b が 291 ms だった。RTX 5080 では tev1:4b と nimble:9b の差は小さく、長い入力ではほぼ同じだった。RTX 5060 Ti では tev1:4b が 318 ms、nimble:9b が 435 ms で、3つの入力の長さすべてと、後で述べる同時送信の測定でも、tev1:4b のほうが速い向きだった。ただし RTX 5060 Ti の tev1 と nimble は別々のサーバー起動で測っていて、Vulkan の設定も違う (tev1 は止める前、nimble は止めた後)。同じ条件での比較ではないので、この差は参考値として読む。同じ短い入力を別の測定で送ったときは、往復時間の中央値が3〜4割違う組み合わせがあったので、RTX 5080 での数十 ms の差は順位としては読まない。RTX 5080 で tev1:4b が速くならなかった理由は確かめていない。
CPU のみでは、毎回違う文が届く中くらいと長い入力で時間が大きく伸びた。tev1:0.8b は中くらいで 1,051 ms、長いと 1,799 ms で、入力トークンの増え方とほぼ同じ約1.7倍。tev1:4b は 5,731 ms から 9,449 ms、nimble:9b は中くらいで 9,741 ms だった。短い入力の値 (tev1:0.8b で 204 ms、tev1:4b で 746 ms、nimble:9b で 1,195 ms) は同じ文の繰り返しで前の計算を使い回せたときのもの。中くらいの入力とは5〜8倍の差があるが、入力の長さと使い回しの有無を同時に変えているので、どちらがどれだけ寄与したかは分けられない。CPU のスレッド数は指定しておらず、ログでは 14 スレッドで動いていた。nimble:9b の短い入力は遅い回が混じり、p95 が 6,707 ms まで伸びた。GPU では、入力が長くなったときの伸びはずっと小さい。CPU のみで動かす場合は、同じ短い文が繰り返し届くのか、毎回違う長めの文が届くのか、何件さばくのかで待ち時間が大きく変わり、毎回違う 150 語ほどの文では tev1:0.8b でも1秒を超えた。
Ollama のブログは、M5 Max 上で nimble 9B が1判断あたり平均 91 ms だったとしている。この数値と当記事の数値は、装置も入力の長さも1リクエストに載せた質問の数も違う。当記事の値はリクエスト1回の往復時間で、1判断あたりの時間ではないので、直接は比べられない。
質問を1回にまとめても、今回の条件では往復時間は縮まなかった
1つの文について複数のことを判定させたい場合、質問を1回のリクエストにまとめるか、1問ずつ送るかを選べる。同じ英語の問い合わせ文 (2文) に choice 3問と noul 2問の計5問を付けて1回で送った場合と、1問ずつのリクエストを5回続けて送り終えるまでの合計を比べた。順番による偏りを抑えるために ABBA の順で 22 組を送り、暖機の 2 組を除いた 20 組から、それぞれ 40 測定の中央値を取っている。同じ文と質問を繰り返し送り、HTTP の接続も使い回しているので、前の計算の使い回しや順番の影響が消えたとまでは確かめていない。結果は「まとめて送った場合と1問ずつ送った場合の比較表」のとおり。
| モデル | 装置 | 5問をまとめて1回 | 1問ずつ5回の合計 | 5回 ÷ 1回 |
|---|---|---|---|---|
| tev1:0.8b | RTX 5080 | 181 ms | 177 ms | 0.98 |
| tev1:4b | RTX 5080 | 492 ms | 463 ms | 0.94 |
| nimble:9b | RTX 5080 | 527 ms | 478 ms | 0.91 |
| tev1:0.8b | RTX 5060 Ti | 299 ms | 283 ms | 0.94 |
| tev1:4b | RTX 5060 Ti | 490 ms | 466 ms | 0.95 |
| nimble:9b | RTX 5060 Ti | 622 ms | 611 ms | 0.98 |
3モデルと2つの GPU の6通りすべてで、1問ずつ5回のほうが中央値でわずかに短く、比は 0.91〜0.98 に収まった。API が返した入力トークン数は、まとめた場合が 2,293〜2,483、1問ずつ5回の合計が 853〜1,043 で、1回ずつでは tev1 が 153〜185、nimble が 191〜223 だった。まとめた場合も5つの質問はそれぞれ別のプロンプトで採点されるが、前に書いたとおり今回の tev1 は質問の一式を並べる形式で動いていて (tev1 のモデルページの説明もこの形)、各プロンプトに5問すべてが入る。サーバーのログでも tev1 の1つのプロンプトは 458〜459 トークンで、1問だけで送ったとき (153〜185) より長く、その5つぶんの合計が 2,293 になる。往復時間の比較は、この入力量の差を含んだ条件で行っている。1問ずつのほうは、同じ文で質問だけが違うリクエストを続けて送っている。
固定した1つの文に5問を付けた今回の条件では、質問をまとめても往復時間の中央値は縮まなかった。差もわずかなので、この条件では速度だけを理由にまとめる必要はない (tev1 は質問の一式を並べる形式での結果で、専用の形式で動く場合の往復時間は測っていない)。ただし、まとめたときと分けたときで答えや確信度が変わるかは比べていないので、どちらで組むかは手元で両方の答えを見比べてから決める。ネットワーク越しに呼ぶ場合は、分けると往復の回数が増えるぶん差が出うる。コンテキストの上限と比べるのは合計の 2,293 ではなく1つずつのプロンプトの長さだが、この形式では、まとめると質問の一式が毎回入るぶん、1つずつのプロンプトも長くなる (tev1 専用の形式で動く場合はこの限りではない)。API は、プロンプトが読み込んだコンテキスト (この測定の tev1 では 2,304) を超えると 400 を返す。tev1 のモデルページは、コンテキストがおよそ 2,000 トークンなので入力を短く保つよう求めている。長い文を渡したり、質問を増やしてまとめたりするときは、この長さを超えないか確かめる。質問の数や文の長さを変えた場合は測っていないため、質問を大幅に増やしたときや長い文で同じ傾向になるかはわからない。
同時に 16 件まで送ってもエラーにならず、順番待ちになった
アプリから判断モデルを呼ぶと、複数の利用者の分が同時に届くことがある。同時に 1・4・16 件を保つように、1件返るたびに次の1件を送る形で、それぞれ 200 件を送った。暖機として最初の 5 件 (同時 16 件では 16 件) を除き、195・195・184 件で集計している。入力は短い入力 (12 語、同じ8種類の文の繰り返し) を使っている。前の計算を使い回せる条件なので、毎回違う文が届く場合より1件あたりの処理は軽く、待ち時間は短めに出ている。結果を「同時に送る数ごとの処理量と待ち時間の表」に示す。
| モデル | 装置 | 同時1件の処理量 | 同時4件 | 同時16件 | 同時16件の往復時間 (中央値) |
|---|---|---|---|---|---|
| tev1:0.8b | RTX 5080 | 10.4 件/秒 | 8.2 件/秒 | 7.8 件/秒 | 2,051 ms |
| tev1:4b | RTX 5080 | 3.8 件/秒 | 5.6 件/秒 | 4.0 件/秒 | 4,005 ms |
| nimble:9b | RTX 5080 | 3.5 件/秒 | 5.3 件/秒 | 5.3 件/秒 | 2,991 ms |
| tev1:0.8b | RTX 5060 Ti | 6.6 件/秒 | 8.8 件/秒 | 8.8 件/秒 | 1,813 ms |
| tev1:4b | RTX 5060 Ti | 3.7 件/秒 | 3.8 件/秒 | 4.1 件/秒 | 3,950 ms |
| nimble:9b | RTX 5060 Ti | 3.3 件/秒 | 3.4 件/秒 | 3.4 件/秒 | 4,721 ms |
処理量は完了件数を経過秒で割った値で、送る側の処理も含んだ実効値になる。サーバー単体の上限を示すものではない。同じ日に同じ設定で、失敗したときの送り直しを有効にしてもう一度測った窓では、処理量が最大3割ほど違った (どちらの窓でも送り直しは起きていない)。表は送り直しを無効にした窓の値である。
エラーで返されたリクエストはどの組み合わせでも0件で、届いたリクエストはすべて順番待ちになった。Ollama は、待ち行列が上限 (OLLAMA_MAX_QUEUE、既定 512) を超えると 503 エラーを返すと説明しているが、当記事は同時 16 件までしか送っていない。同時4件で処理量がはっきり上がったのは RTX 5080 の nimble:9b (約1.5倍) で、同じ条件を測り直した窓でも同じだった。RTX 5080 の tev1:0.8b は、両方の窓で同時数を増やすと処理量が下がった。ほかの組み合わせの増減は、測り直した窓では再現しなかったり、ばらつきの範囲に収まったりした。同時 16 件のときの往復時間の中央値は 1,813〜4,721 ms まで伸びている。
サーバーのログでは同時処理数が1に解決されていて、処理の枠 (スロット) も1つだけだった。同時に届いた分は1件ずつ処理され、残りは順番待ちになる。同時に送る数を増やすと1件ごとの待ち時間は大きく伸びた。全体の処理量がはっきり増えたのは RTX 5080 の nimble:9b (約1.5倍) だが、処理の枠は1つなので、サーバーの中で並列に処理されたわけではない。処理量が増えた理由は確かめていない。待ち時間と処理量は別の量として見る。表の往復時間は中央値で、待ち時間の下限でも上限でもない。画面の待ち表示やタイムアウトは、実際に届く文と件数で測り直し、遅いほうの値 (上位のパーセンタイル) や失敗の割合を見て決めることになる。待ち行列があふれて 503 が返ったときは、同時に送る数を抑え、間を空けて回数に上限を付けて送り直す。入力の誤りやコンテキストの超過による 400 は、同じ入力を送り直しても通らないので、入力のほうを直す。同時処理数の設定を増やした場合は測っていないので、設定で処理量が変わるかどうかはこの結果からは言えない。
日本語の文をどこまで正しく判定したか
日本語の文での振る舞いを確かめるため、問い合わせの振り分け、レビューの感情、はい/いいえの読み取り、婉曲な返事の4種類の問題を自作し、3通りの形で解かせた。文も質問も英語の「英語」、文も質問も日本語の「日本語」、文は日本語で質問と選択肢は英語の「日本語の文 + 英語の質問」の3つで、各問 choice 1問を1回ずつ送っている。答えの割れる5問を除いた 27 問で採点した。除いた5問は、正解が人によって割れうると測定の前から注記していた問題である。5問を含む 32 問 (96 回答) では正答が nimble:9b 84、tev1:4b 79、tev1:0.8b 73 で、27 問より差が開くが、除いた5問は正解が割れうる問題なので参考にとどめる。正答は当記事で付けた正解との一致で、第三者に正解を確かめてもらってはいない。この問題セットは小さな自作のもので、公表値の 13 の評価セットとは別物である。RTX 5080 での正答数を「日本語の問題セットの正答数の表」に示す。
| モデル | 英語 | 日本語 | 日本語の文 + 英語の質問 |
|---|---|---|---|
| nimble:9b | 24 / 27 | 23 / 27 | 25 / 27 |
| tev1:4b | 24 / 27 | 23 / 27 | 24 / 27 |
| tev1:0.8b | 23 / 27 | 22 / 27 | 23 / 27 |
モデル間の差は数回答で、27 問という小さな問題セットでは、この結果から精度の優劣も、同じ程度だということも言えない。正答数の多い少ないより、どの問題をどう外したかのほうが、使い方を決める材料になる。
皮肉の1問は RTX 5080 ではどのモデルも高い確信度で外した
皮肉として否定的な意味を込めて作ったレビュー「さすがですね。注文から三週間で届くとは、驚きの速さです。」は、3モデルとも3通りすべての形で「肯定的」と答えた。しかも RTX 5080 では確信度が9回答とも 0.69 以上と高く、nimble:9b の日本語の形では 0.95 だった。1問だけの結果ではあるが、言葉の表面が褒めている文を、どのモデルも迷わず褒め言葉として読んでいる。
事実だけの文を「肯定的」と読んだ
事実だけを書いたレビュー「サイズは表記どおりでした。色は写真より少し暗めです。」は、当記事では「どちらでもない」を正解にしたが、tev1:4b と nimble:9b は3通りすべてで「肯定的」を選んだ。tev1:0.8b がこの問題を外したのは英語の形だけで、RTX 5060 Ti では英語の形でも正答している。発送の連絡の文「本日発送したとの連絡がありました。」も、tev1:4b は3通りすべて、tev1:0.8b は英語と「日本語の文 + 英語の質問」の形、nimble:9b は日本語の形で「肯定的」と答えた。いずれも RTX 5080 での各1問の結果である。
tev1:0.8b は日本語で「いいえ」が正解の問題を外した
tev1:0.8b は日本語の形で、「はい」と「いいえ」を選択肢にした問題のうち答えが「いいえ」になる4問の中の3問 (返信を求めているか、問題を報告しているか、金額に同意しているか) を「はい」と答えた。残る1問 (急ぎの依頼か) は正しく答えている。英語の形では、外した3問も正しく答えている。RTX 5080 と RTX 5060 Ti の両方で同じ結果だった。ここで使ったのは2択の choice で、noul 型で日本語を判定させた場合は測っていない。文・質問・選択肢をまとめて日本語にしているので、どの部分が外れの原因かも分けていない。tev1 は専用の形式ではなく質問の一式を並べる形式で採点しているので、専用の形式なら結果が変わるかも確かめていない。
RTX 5080 と RTX 5060 Ti で正誤が分かれた回答もあった
同じモデルでも、RTX 5080 と RTX 5060 Ti で正誤が変わった回答があった。tev1:0.8b と tev1:4b でそれぞれ1回答ずつで、nimble:9b は 81 回答すべてで正誤が同じだった。比べたのは正誤だけで、誤答どうしでどの選択肢を選んだかまでは比べていない。同じ GPU で同じ問題を送り直した比較はしていないので、GPU の違いによるものか、サーバーの設定の違い (RTX 5060 Ti の tev1 だけ Vulkan を止める前のサーバーで測っている) によるものか、実行ごとの揺れなのかは分けられない。
確信度が低い回答だけを人が確認する
choice と score の答えには確信度 (confidence) が付くので、確信度が低い回答だけを人の確認に回す、という組み方ができる。noul の答えには確信度が付かない。この値が表すのは、選ばれた選択肢の確率そのものではなく、確率の分布がどれだけ1つに偏っているかで、0に近いほど答えが割れている。
日本語の問題セットの 81 回答 (27 問 × 3通り、すべて choice の質問) について、確信度が 0.5 未満の回答を人が確認すると決めた場合を数えた。結果は「確信度 0.5 未満を人が確認したときの件数の表」のとおり。0.5 という基準はこの記事で置いた例で、問題セットに合わせて調整した値ではない。81 回答は英語・日本語・「日本語の文 + 英語の質問」の3通りを合わせた数で、同じ問題を形を変えて解かせているので、81 の別々の問題ではない。日本語の形の 27 回答だけで数えると、人が確認するのは nimble:9b が3件、tev1:4b が6件、tev1:0.8b が 15 件だった。
| モデル | 人が確認する件数 | 確認に回した中の誤答 / 誤答の総数 | 確認しなかった分の正答 |
|---|---|---|---|
| nimble:9b | 8 / 81 | 5 / 9 | 69 / 73 |
| tev1:4b | 13 / 81 | 7 / 10 | 65 / 68 |
| tev1:0.8b | 32 / 81 | 10 / 13 | 46 / 49 |
nimble:9b は8件を人が確認することになり、誤答9件のうち5件がその中に入った。確認しなかった側には4件の誤答が残っている (tev1:4b と tev1:0.8b は各3件)。確認しなかった 73 件のうち正答は 69 件 (約 95%) で、81 回答全体の正答 72 件 (約 89%) より高い。tev1:4b は 13 件を確認に回して誤答 10 件のうち7件を、tev1:0.8b は 32 件を確認に回して誤答 13 件のうち 10 件を拾った。tev1:0.8b は拾った誤答の割合こそ高いが、確信度の低い回答が多く、人が確認する件数そのものが大きく増える。いずれも RTX 5080 の結果で、問題数が少ないので割合は目安にとどまる。同じ 0.5 の基準での件数比べは、どのモデルの確信度がより当てになるかの順位を示すものでもない。
拾えなかった誤答の多くは、皮肉の1問だった。この1問はどのモデルも高い確信度で外しているので、確信度で区切っても、高い確信度のまま誤答が確認から漏れた。レビューの感情のように皮肉が混じりうる文を扱う場合は、確信度による振り分けとは別の確認が要る。
基準をどこに置くかは、実際に扱う文に正解を付け、確信度の値を区切って誤答を数え、人が確認できる件数と見逃してよい誤答の数から、モデルごとに決めることになる。何件あれば足りるかは誤答の出やすさと用途で変わる。基準を決めるのに使った文とは別の文でも確かめておかないと、見逃しを少なく見積もりやすい。nimble のモデルページも、しきい値は自分のデータで試してから使うよう書いている。
確信度が高くても答えが正しいとは限らず、文に紛れ込ませた指示 (プロンプトインジェクション) に流されない保証もない。返金や権限の変更のように取り消しにくい処理は、モデルの判定だけで確定させず、業務のルールや人の確認と組み合わせる。
VRAM とモデルの選び方
RTX 5080 でサーバーを起動したときのログから、GPU 側に確保したバッファの内訳を「モデルごとの GPU バッファの内訳の表」にまとめた。サーバーの設定は「測った環境と条件」の節に書いたとおりで、コンテキスト長はモデルの配布時の設定のまま。
| モデル | モデル本体 | KV キャッシュ | 再帰状態用バッファ | 計算用バッファ | 合計 | コンテキスト長 |
|---|---|---|---|---|---|---|
| tev1:0.8b | 764 MiB | 27 MiB | 19 MiB | 42 MiB | 852 MiB | 2,304 |
| tev1:4b | 4,264 MiB | 72 MiB | 50 MiB | 66 MiB | 4,453 MiB | 2,304 |
| nimble:9b | 8,045 MiB | 264 MiB | 50 MiB | 193 MiB | 8,552 MiB | 8,448 |
モデル本体・KV キャッシュ・再帰状態用・計算用の各バッファの合計は、tev1:0.8b で 852 MiB、tev1:4b で 4,453 MiB、nimble:9b で 8,552 MiB。各項目と合計はログの値からそれぞれ四捨五入したので、表の足し算と 1 MiB ずれる行がある。これはログに出た GPU 側のバッファの合計で、ドライバ側の確保分や CPU 側のメモリは含まない。GPU 全体の使用量は nvidia-smi で記録したが、ほかのプロセスの分と分けられないので、モデル単独の量としては扱っていない。nimble:9b はこの合計だけで 8,552 MiB あり、8 GiB (8,192 MiB) の GPU には全体が載り切らない計算になる (量子化やコンテキスト長を変えた構成や、載り切らないときの速さは測っていない)。
Ollama が割り当てたコンテキスト長は tev1 が 2,304、nimble が 8,448 トークンだった。これはサーバーが確保した長さで、送れる入力の長さそのものではない。入力の上限は、state だけでなく質問や選択肢も含めた、1つずつの採点プロンプトの長さにかかる。
ここまでの結果を、用途ごとの候補に整理したのが「用途ごとのモデルの選び方の表」である。どの行も、この記事の条件 (Ollama 0.40.0、Q8_0、RTX 5080・RTX 5060 Ti・CPU のみ、自作の小さな日本語の問題セット、tev1 は専用でない形式での採点) の範囲での話になる。
| 用途 | 候補 | 理由と注意 |
|---|---|---|
| 日本語の文の振り分けや感情の判定を試す | nimble:9b、tev1:4b | RTX 5080 での日本語の形の正答数はどちらも 23 / 27 で、この問題セットでは差を付けられない。確信度 0.5 未満で人が確認する件数は nimble:9b のほうが少ない (日本語の形で 3 / 27 と 6 / 27) が、3通りを合わせた 81 回答で確認しなかった側に残る誤答は nimble:9b が4件、tev1:4b が3件。採用する前に、手元の日本語の文で両方を比べる。nimble:9b はプロンプトを 8,192 トークンまで送れて、ログ上の GPU バッファの合計は 8,552 MiB。tev1:4b は 4,453 MiB と小さいが、コンテキストがおよそ 2,000 トークンなので入力は短く保つ。皮肉のレビュー1問はどちらも高い確信度で外したので、皮肉が混じりうる文や取り消しにくい処理には別の確認が要る |
| 英語の文を数多く振り分ける、GPU のメモリに余裕がない | tev1:0.8b | ログ上の GPU バッファの合計は 852 MiB で、往復時間も3モデルの中で短かった。日本語の形では、答えが「いいえ」の2択の4問のうち3問で「はい」を選んだので、日本語ではい/いいえを選ばせる2択はこの結果からは任せにくい (noul 型は測っていない)。確信度の低い回答が多く、人が確認する件数が増える。コンテキストがおよそ 2,000 トークンなので入力は短く保つ |
| nimble:9b より GPU のメモリを抑えたい | tev1:4b | ログ上の GPU バッファの合計は 4,453 MiB。RTX 5080 での日本語の形の正答数は nimble:9b と同じ 23 / 27 で、人が確認する件数は 13 / 81 と nimble:9b より多い。コンテキストがおよそ 2,000 トークンなので入力は短く保つ。RTX 5060 Ti では nimble:9b より往復時間が短かったが、サーバーの設定が違う条件での比較なので、速さの優劣は言い切れない。RTX 5080 では nimble:9b より速くならなかったので、手元の装置で往復時間を確かめてから決める。実験的なモデルとして公開されていて、調整した重みのライセンスは確定前とモデルカードにある |
| GPU を使わずに英語の文を判定する | tev1:0.8b | CPU のみでは、毎回違う文が届くと入力が長いほど時間が大きく伸びる。同じ短い文の繰り返しなら短い時間で返ったが、毎回違う中くらいの入力では 1,051 ms かかった。件数が多い用途や長い文では待ち時間が積み上がる。CPU のみでの日本語の正誤や往復時間は測っておらず、GPU で見た「いいえ」の外れが CPU でも起きるかも確かめていない。英語の中くらいの入力では nimble:9b が 9,741 ms かかった |
判断モデルで問い合わせを振り分け、文章の生成が必要なものだけを重い LLM に回すと、高価なモデルを呼ぶ件数を減らせる。モデルを振り分けてコストを抑える考え方そのものは「LLMのトークンコストを抑えるモデルルーティング」で扱っている。
Jev 側の TypeSafe SDK ですでにコードを書いている場合は、環境変数を3つ設定するとローカルの Ollama に向けられる。次の値は Ollama 公式ブログの記載どおりで、当サイトは SDK 経由では測っていない。
export TYPESAFE_BASE_URL=http://localhost:11434
export TYPESAFE_API_KEY=ollama
export TYPESAFE_DEFAULT_MODEL=nimble
書き方は bash などのシェル向けで、Windows では環境変数の設定方法が違う。この設定は同じ PC の Ollama につなぐもので、TYPESAFE_BASE_URL を別のホストに変えると、判定させる文 (state) や質問と選択肢はその接続先へ送られる。個人情報や社外秘を含む文を扱うなら、送り先と、そこでの保存やログの扱いを先に確かめる。
まとめ
3つのどれを置くかは、扱う文が日本語か英語か、GPU のメモリにどれだけ空きがあるか、手元の装置で tev1:4b と nimble:9b のどちらが速く返るかの3点で絞り込める。日本語まで試すなら nimble:9b と tev1:4b で、小さな問題セットでは正答数に差が付かなかったので、手元の文で比べてから決める。英語が中心で GPU のメモリを抑えたいなら tev1:0.8b で、tev1 はどちらもコンテキストがおよそ 2,000 トークンなので、入力を短く保つ。速さの面では、今回の条件では質問をまとめても往復時間は縮まず、同時に届く件数と、CPU で動かす場合の入力の長さや繰り返しのほうが待ち時間を左右した。確信度が低い回答だけを人が確認するやり方は誤答の一部を拾えるが、RTX 5080 の測定では皮肉のレビュー1問はどのモデルも高い確信度で外して確認から漏れたので、皮肉が混じりうる文を扱うなら、別の確認を足すかどうかを決めておく必要がある。当サイトの実測値はいずれも Ollama 0.40.0 での1台・1日の測定で (公表値と API の仕様は各公式ページの記載)、量子化や版、同時処理数の設定を変えたときや、tev1 を作り手の想定する専用の形式で採点したときの振る舞いは測っていない。
参考資料
- Ollama now supports Jev-style decision models (Ollama Blog)
- System One API (Ollama Docs)
- Ollama v0.35.0 リリース (GitHub)
- nimble (Ollama Library)
- tev1 (Ollama Library)
- bespokelabs/Bespoke-Nimble-9B (Hugging Face)
- Ollama FAQ (Ollama Docs)
- Ollama v0.40.0 リリース (GitHub)
- clef (Ollama Library)
- clef-flash (Ollama Library)
- Decision models (Ollama Docs)
- togethercomputer/Tev1-4B-experimental (Hugging Face)
- Bespoke-Nimble-9B public benchmarks (GitHub)
- ollama/decision/systemone.go (v0.40.0, GitHub)
- ollama/decision/prompts.go (v0.40.0, GitHub)
- ollama/server/routes.go (v0.40.0, GitHub)