この記事の要点
Windows の Ollama で、日本語の文を音声にできた。ただし自動の文字起こしで読み戻すと多くの回でどこかが元の文と食い違い、別の語への置き換わりや、文が二つある入力で片方の文が出てこない例があった。音声と文字起こしのどちらの誤りかは切り分けていないので、読み違いが困る用途では作った音声を聞いて確かめてから使う。GPU と CPU だけとで、正確さの違いは見えなかった。
モデルを読み込んだ後なら、Core i7-14700F の CPU だけでも、音声の長さより短い時間で作り終えた。ただし返ってくる WAV の頭に無音が入るので、そのまま再生すると、声が聞こえるまでにその分の待ちが加わる。
Windows で日本語を送るときは、コマンドに直接書かず、BOM なしで保存した JSON ファイルから送る形にすると、試した3つのシェルのどれでも日本語の音声が返った。
LFM3-Omni-2BはOllamaで日本語を読み上げられるか
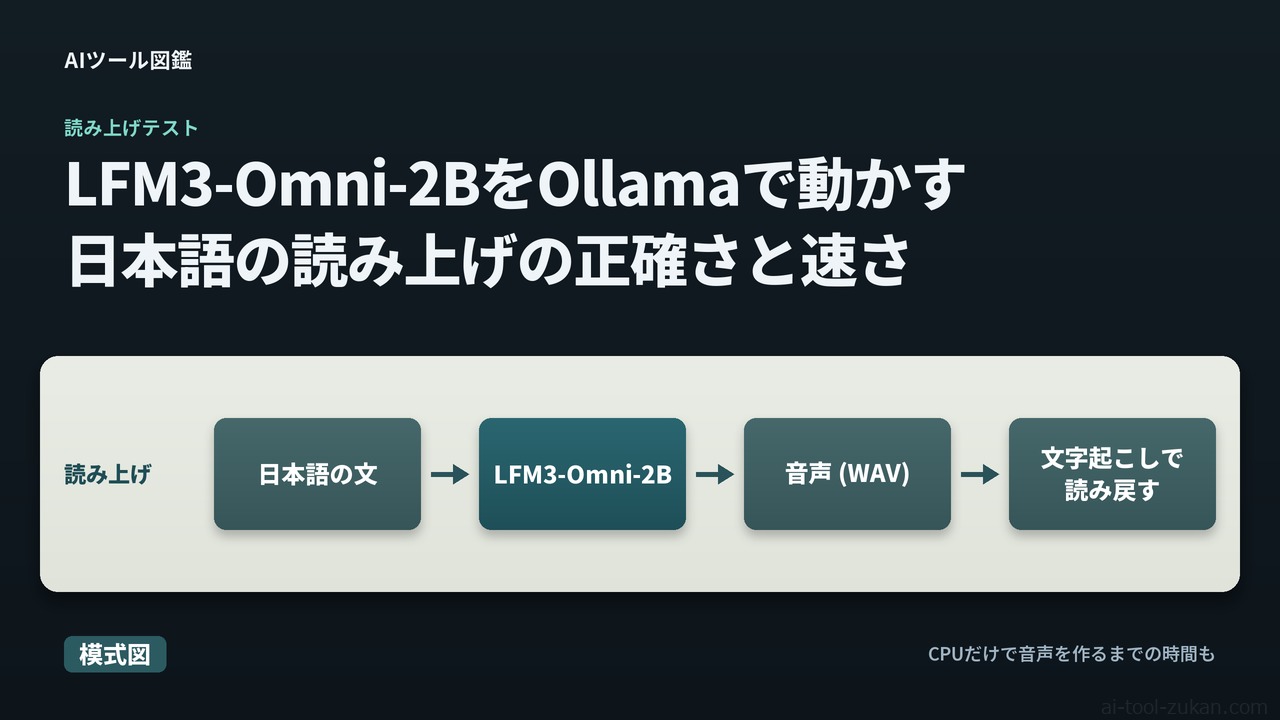
Windows 11 の Ollama 0.40.13 で LFM3-Omni-2B に日本語の文の読み上げ (音声合成 (TTS)) をさせると、音声 (WAV) が返った。日本語10文を3回ずつ読ませた30件を、自動の文字起こしで読み戻して元の文と比べた。この測定を4回行った (RTX 5080 で2回、RTX 5060 Ti と CPU だけで1回ずつ)。1件ごとに食い違った文字の割合 (文字誤り率) を出し、測定ごとに平均すると9.8〜16.1%だった。どの測定でも30件のうち20件以上で、文字起こしのどこかが元の文と違った。GPU と CPU だけの違いは、同じ条件の2回の開きに埋もれて見えなかった。
速さは、モデルを読み込んだ後なら、1文 (約5秒の音声) を作り終えるまでの時間の中央値が RTX 5080 で0.387秒、RTX 5060 Ti で0.574秒、CPU だけ (Core i7-14700F) でも2.405秒だった。作り終えるまでの時間を音声の長さで割った値を RTF と呼び、1より小さければ再生より速く作れている。CPU だけでも RTF の中央値は0.47だった。ただし返ってくる WAV の頭には日本語で約0.5〜1.6秒の無音が入るので、そのまま頭から再生すると、声が聞こえるまでにその分の待ちが加わる。この速さは Core i7-14700F で測ったもので、自分の PC で速さの目安を見る方法は「GPUとCPUで、音声を作り終えるまでの時間」の節の最後に書いた。
使う前に聞いて確かめられる用途や、あらかじめ作っておく音声なら試しやすい。ただ文字起こしでは、パソコンのような日常の語も別の語になり、2文の入力では片方の文が出てこないこともあった。音声と文字起こしのどちらで起きたかは切り分けていないが、聞かずにそのまま流す使い方では、こうした食い違いがあっても気づけない。
Windows で日本語を送るときは、UTF-8 (BOM なし。BOM はファイルの先頭に付く目印のバイト列) で保存した JSON ファイルを --data-binary で送る形に揃えると、試した3つのシェル (Git Bash・Windows PowerShell・コマンドプロンプト) のどれでも日本語の音声が返った。コマンドに日本語を直接書いたときの結果は、手順の節の注意にまとめた。
ローカルで動かせるほかの音声合成モデルは、オープンTTS(音声合成)モデル比較で取り上げている。
LFM3-Omni-2Bとは: 文字・画像・音声を受けて、文字と音声で返す2Bのモデル
Hugging Face のモデルカード (2026年10月30日閲覧) によると、LFM3-Omni-2B は Liquid AI が公開した LFM3 ファミリーで最初の omni モデルで、1つのモデルで文字・画像・動画・音声を理解し、文字と音声で答える。パラメータ数は合計2.17B とされている。
モデルカードに書かれている入力と出力は次のとおり。
- 入力: 文字、画像、動画 (音声つきも可)、16kHz の音声
- 出力: 文字、24kHz の音声、文字と音声の混在
- 音声出力の対応: 19の言語・地域で、日本語が含まれる (英語は米国と英国の2つとして数えられている)
- 文字の対応言語: 16で、ここにも日本語が含まれる
一方で、モデルカードに載っている音声合成の評価は英語だけで、Seed-TTS-eval の英語で UTMOSv2 が3.80 (1〜5の尺度で、高いほど良い) と書かれている。2026年10月30日に閲覧したモデルカードの評価表には、日本語の読み上げの評価の数値は載っていなかった (モデルカード以外の資料までは調べていない)。そこでこの記事では、日本語の読み上げを手元の10文で測った。
ライセンスは LFM Open License v1.0 で、年間の売上が1,000万米ドル以上の法人による商用利用は、このライセンスでは許諾されていない (LICENSE 第1条・第5条)。第1条の定義では、ここでいう法人 (Legal Entity) は、その法人に加えて、その法人を支配する法人、その法人に支配される法人、その法人と共通の支配下にある法人も合わせたものを指す。会社などで使う場合は LICENSE の全文を確認する。
測定には、2026年10月28日 (UTC。日本時間では29日) に公開された Ollama 0.40.13 を使った。このバージョンのリリースノートには、lfm3-audio と lfm3-omni の音声合成を含む LFM3 のモデルが、Apple シリコンに加えて Linux と Windows でも動くとある。
表「Ollama 0.40.13 で試した使い方」は、2026年10月30日に Windows の Ollama 0.40.13 で試した2つの使い方と、その結果を並べたもの。
| 使い方 | 今回の結果 |
|---|---|
文を渡して読ませる (/v1/audio/speech) |
音声 (WAV) が返った |
チャット (/api/chat) で話しかける |
返答は文字で返った。音声で返させるほかの方法は試していない |
モデル自体は文字と音声を混ぜて答えられるとモデルカードにはあるが、Ollama のドキュメント (Speech) に書かれていたのは、文を渡して読ませる /v1/audio/speech の使い方だった。そこでこの記事では、返答を声にする形として、文字の返答を /v1/audio/speech に渡す2段の形を前提にし、チャットと読み上げを別々に測った。2つをつないだときの時間は測っていない。
Ollamaで日本語を読ませる手順
まず手元の Ollama のバージョンを確かめる。
ollama --versionollama --version でバージョンが表示される。0.40.13 より古い場合は、Ollama を更新してからモデルを取得する。0.40.13 より古いバージョンでは試していない。
次にモデルを取得する。
ollama pull lfm3-omni:2b表「試したタグとファイルの大きさ」は、今回取得した3つのタグで、ダウンロードされるモデル本体の大きさを並べたもの。どのタグにも、画像・音声を扱う部分 (projector) の0.95GB が加わる。
| タグ | 量子化 | モデル本体 |
|---|---|---|
lfm3-omni:2b (latest と同じ) |
Q4_K_M (Windows で取得したもの) | 1.10GB |
lfm3-omni:2b-q8_0 |
Q8_0 | 1.85GB |
lfm3-omni:2b-bf16 |
BF16 | 3.47GB |
既定の lfm3-omni:2b なら、projector と合わせて合計約2.05GB になる。大きさは Ollama が保存したファイルのバイト数を10進の GB に直した値。まず動かしてみるなら、今回の3つのタグでモデル本体がいちばん小さい既定の lfm3-omni:2b から始められる。量子化を変えた結果は「日本語の読み上げはどのくらい正確か」の節に書いた。どれがより正確かは、今回の測り方では決められなかった。
Windows の Ollama 0.40.13 では lfm3-omni:2b は Q4_K_M のファイルとして取得されたが、Mac で同じファイルになるかは確かめていない。今回と同じ Q4_K_M を明示して取りたいときは、ライブラリにタグ lfm3-omni:2b-q4_K_M もある。Ollama のライブラリには MLX 形式のタグ (2b-mlx-bf16・2b-mxfp8・2b-nvfp4) もあるが、今回は試していない。
読ませたい文を JSON ファイルに書き、BOM なしの UTF-8 で保存する (例: speech_ja.json)。
{
  "model": "lfm3-omni:2b",
  "input": "ご注文の商品は、本日発送いたしました。",
  "voice": "female-japanese",
  "response_format": "wav"
}
表「JSON の指定」は、このファイルに書いた4つの指定の意味をまとめたもの。
| 指定 | 意味 |
|---|---|
"model": "lfm3-omni:2b" |
取得したタグ |
"input": "ご注文の商品は、本日発送いたしました。" |
読ませる文。Ollama のドキュメントでは1回のリクエストで4,096文字まで (長い文は試していない) |
"voice": "female-japanese" |
声。日本語は female-japanese か male-japanese |
"response_format": "wav" |
返ってくる音声の形式。ドキュメントでは wav (既定) か pcm を選べる。今回は wav だけを使った |
声の名前は、Ollama v0.40.13 のソースコード (model/renderers/lfm3_speech.go) の声の一覧の組み立てでは、default か、female-言語名 / male-言語名 の形になっている。voice が空か default のときは米国英語の女性の声になるので、日本語の文には female-japanese などを指定する。今回は female-japanese だけを使い、日本語の音声が返ることを確かめた。male-japanese と、default のまま日本語を読ませた場合は試していない。
Windows PowerShell 5.1 でこのファイルを作るなら、BOM を付けない UTF-8 で書き込む .NET の機能を使う形がある。@' と '@ の間に JSON をそのまま書き、'@ は行の先頭に置く。
$json = @'
{
  "model": "lfm3-omni:2b",
  "input": "ご注文の商品は、本日発送いたしました。",
  "voice": "female-japanese",
  "response_format": "wav"
}
'@
[System.IO.File]::WriteAllText((Join-Path (Get-Location).Path 'speech_ja.json'), $json, (New-Object System.Text.UTF8Encoding($false)))
この形で作ったファイルの先頭に BOM が無く、UTF-8 の JSON として読めることを、2026年10月30日に測定機の Windows PowerShell 5.1 で確かめた (スクリプトファイルにして実行した)。
JSON ファイルを保存したフォルダで、ファイルを --data-binary で送り、返ってきた音声を WAV で保存する。
curl.exe http://localhost:11434/v1/audio/speech -H "Content-Type: application/json" --data-binary "@speech_ja.json" --output speech_ja.wav表「curl.exe の指定」は、このコマンドの各指定の意味をまとめたもの。
| 指定 | 意味 |
|---|---|
http://localhost:11434/v1/audio/speech |
送り先。この PC で動いている Ollama (localhost) の読み上げの /v1/audio/speech。別のサーバーの URL に変えると、JSON に書いた文はそのサーバーへ送られる |
-H "Content-Type: application/json" |
送る中身が JSON であることを Ollama に伝える |
--data-binary "@speech_ja.json" |
ファイルの中身を書き換えずにそのまま送る。@ の後ろがファイル名 |
--output speech_ja.wav |
返ってきた音声を保存するファイル名 |
PowerShell では curl.exe と書き、@ で始まるファイル名は引用符で囲む。Windows PowerShell 5.1 では、curl とだけ書くと Invoke-WebRequest の別名になるからだ。引用符で囲むのは、@speech_ja.json を引用符で囲まないと、コマンドが実行される前に構文のエラーになるからだ。Microsoft のドキュメント (curl on Windows) によると、PowerShell 7 以降にはこの別名はないが、この記事では curl.exe に揃えている。
このコマンドは、2026年10月30日に測定機 (Windows 11、Ollama 0.40.13) の Git Bash (mingw64 の curl 8.18.0)・Windows PowerShell 5.1・コマンドプロンプト (どちらも Windows の curl.exe) で打ち、どれでも日本語の音声が返った。測定では Ollama を別のポート番号で起動していたので、送り先のポート番号だけ書き換えて打った。返った音声を自動の文字起こしで読み戻すと、どのシェルでも元の文の骨組み (注文…本日…いたしました) は残っていた。一方、語が別の語に置き換わる食い違いは、後の節の正確さの測定と同じように出た。
Mac・Linux では curl.exe の代わりに curl と書く。これは一般的な curl の呼び方で、手元では試していない。
返ってきたのは 24kHz・16bit・モノラルの WAV だった (2026年10月30日に受け取ったファイルのヘッダーで確かめた)。
この記事の Windows での手順は、試した3つのシェルのどれでも結果を確かめられた、UTF-8 (BOM なし) で保存した JSON ファイルから送る形に揃えている。
測定機の Git for Windows の bash (mingw64 の curl 8.18.0) から、curl の -d に日本語を直接書いて送ると、HTTP 200 で音声は返ったが、自動の文字起こしでは元の文とまったく別の言葉になった。同じ bash からチャットで送ると、モデルは「文字化けした文字列」と答えた。送られたバイト列は調べておらず、どこで文字が化けたのかは特定していない。同じ文を UTF-8 で保存した JSON ファイルに入れ、--data-binary で送ると、文字起こしが元の文に近い音声が返った。中国語・韓国語も直接書くと同じ結果で、フランス語・ドイツ語・スペイン語は直接書いても文字起こしが元の文に近かった。
同じ JSON を BOM 付きの UTF-8 (先頭に EF BB BF の3バイトが付く形) で保存して Git Bash の curl から送ると、HTTP 400 のエラー (invalid character) で受け付けられなかった。Windows PowerShell 5.1 で JSON ファイルを作るとき、次の書き方では BOM なしの UTF-8 にならない。Microsoft のドキュメント (about_Character_Encoding、PowerShell 5.1) によると、> や Out-File は UTF-16、Set-Content -Encoding UTF8 は BOM 付きの UTF-8、-Encoding を省いた Set-Content はシステムの ANSI コードページでファイルを書く。UTF-16 や ANSI で作ったファイルを送った結果は確かめていない。
PowerShell 5.1 から curl.exe に日本語を直接書く形は、測定機では文字起こしが元の文に近かったが、その PowerShell は出力の文字コードを UTF-8 に設定してあった。既定の PowerShell での直書きは確かめていないので、PowerShell でも日本語は JSON ファイルから送る。
Ollama を API として呼ぶ基本の使い方は、Ollama をローカル API サーバーにして社内アプリから LLM を呼ぶに書いた。
日本語の読み上げはどのくらい正確か
正確さは、作った音声を自動の文字起こし (faster-whisper の large-v3-turbo、言語を指定) で読み戻し、元の文と比べて測った。1件ごとの文字誤り率は、文字起こしの結果を元の文に直すのに要る文字の置き換え・削除・挿入の最小の回数を、元の文の文字数で割った値。比べる前に、元の文と文字起こしの両方を NFKC で正規化し、空白と句読点・記号を除き、英字を小文字にそろえた (除いた記号は「測定の環境と条件」の節に書いた)。文字起こしが元の文をどれだけ再現できたかを表す値で、聞いた印象の自然さではなく、Whisper 自身の聞き違いも混じる。
表「装置ごとの文字誤り率」は、日本語10文を3回ずつ (30件) 読ませた測定4回の結果を並べたもの。
| 装置 | 文字誤り率 平均 | 文字誤り率 中央値 | 文字起こしが一致した回 (正規化の後) |
|---|---|---|---|
| RTX 5080 (1回目) | 16.1% | 11.5% | 7 / 30 |
| RTX 5080 (2回目) | 9.8% | 10.0% | 8 / 30 |
| RTX 5060 Ti | 12.6% | 10.0% | 10 / 30 |
| CPU だけ | 12.5% | 10.0% | 10 / 30 |
条件はどれも Ollama 0.40.13、lfm3-omni:2b (Q4_K_M)、voice は female-japanese。RTX 5080 は同じ条件で2回測った。
いちばん高い値といちばん低い値は、どちらも同じ条件の RTX 5080 の測定で出た。測った回数が少なく、装置による差と回ごとの揺れを切り分けられないので、GPU と CPU だけの文字誤り率の差は判定しない。RTX 5060 Ti と CPU だけは1回ずつしか測っていないので、数ポイントの差があっても見分けられない。
どんな食い違いが起きたか
日本語の文字起こしには、語が別の語に置き換わった例と、2文の入力で片方の文が出てこない例があった。表「食い違いの例」は、文字起こしの結果をそのまま載せたもの (句読点は Whisper の出力のまま)。
| 読ませた文 | 文字起こしの結果 | 装置 |
|---|---|---|
| ご注文の商品は、本日発送いたしました。 | ご注文の就任は今時誘ういたしました | RTX 5080 (1回目) |
| パソコンの電源を入れても、画面が真っ暗なままです。 | パクションの電源を入れても画面がシンティレなままです | CPU だけ |
| この料理は、野菜をたっぷり使っていて体に優しい味です。 | この料理は野菜をたっぷり使っていて体に素晴らしいマジです | RTX 5080 (2回目) |
| ありがとうございます。助かりました。 | ありがとうございます | CPU だけ |
| こんにちは。今日はとても良い天気なので、散歩に行きましょう。 | 今日はとても良い天気なので散歩に行きましょう | RTX 5080 (1回目) |
文字起こしでは、商品→就任、発送→誘う、パソコン→パクションのような置き換わりが出た。パソコンは、4回の測定の12件 (各測定3回) のどれでも、文字起こしに「パソコン」と出てこなかった。
2つの文からなる入力では、文字起こしで片方の文が出てこなかったり崩れたりすることがあった。「ありがとうございます。助かりました。」は12件のうち、文字起こしが元の文どおりだったのが4件だった。2文目の「助かりました」が文字起こしに出てこなかったのは5件で、そのうち1文目が元どおりだったのが2件、1文目も崩れていたのが3件だった。「こんにちは。今日はとても良い天気なので、散歩に行きましょう。」は、12件のうち3件で、文字起こしの1文目が抜けるか崩れた。
同じ文でも、測定や回によって、文字起こしが元の文どおりになったり食い違ったりした。表「食い違いの例」には Whisper の聞き違いが混じっている可能性があり、食い違いが読み上げの側で起きたのか文字起こしの側で起きたのかは切り分けていない。
日本語の読みでつまずく例は、別の音声合成モデルについてF5-TTSは日本語で使えるかでも扱っている。
英語の結果と、回ごとの揺れ
英語5文を3回ずつ (15件、voice は female-american-english) 読ませる測定を、RTX 5080 で2回、RTX 5060 Ti と CPU だけで1回ずつ行うと、単語誤り率 (文字誤り率を単語の単位で数えたもの) の平均は0〜0.6% で、RTX 5080 の2回はどちらも0だった。15件のうち14〜15件で、文字起こしが元の文と一致した (正規化の後)。ただし英語は文も数え方 (単語単位) も違うので、日本語と同じ物差しで比べたものではない。
日本語では、RTX 5080 で条件を変えずに2回測ると、文字誤り率の平均は16.1%と9.8%で、丸める前の値では約6.2ポイント開いた。
量子化と、動かすソフトを変えた場合
RTX 5080 で、量子化 (Q4_K_M・Q8_0・BF16) と、実行するソフトを変えて同じ日本語30件を読ませた。llama.cpp は、Ollama とは別の、モデルを動かすソフトで、b11979 の llama-tts に Ollama が保存した Q4_K_M と同じファイルを渡し、声は female・言語は日本語を指定した。表「量子化と動かすソフトごとの結果」は、その4つの条件を並べたもの。
| 条件 | モデル本体 | Ollama の報告値 (size_vram) | 文字誤り率 平均 | RTF |
|---|---|---|---|---|
| Ollama・Q4_K_M (lfm3-omni:2b) | 1.10GB | 1.29GiB | 16.1% (1回目) / 9.8% (2回目) | 0.073 (1回目) / 0.074 (2回目) |
| Ollama・Q8_0 (lfm3-omni:2b-q8_0) | 1.85GB | 1.98GiB | 8.9% | 0.085 |
| Ollama・BF16 (lfm3-omni:2b-bf16) | 3.47GB | 3.49GiB | 10.2% | 0.108 |
| llama.cpp・Q4_K_M | 1.10GB | — | 11.1% | 0.094 (測り方が違うので比べない) |
「Ollama の報告値 (size_vram)」は、Ollama の /api/ps が返す size_vram を GiB に直した値で、GPU 全体の使用量や、動かすのに要る VRAM の量を示す値ではない。RTX 5060 Ti では、日本語30件の測定を終えた後の GPU 全体の使用量が3,052MiB だった (詳しくは「メモリの使用量」の節)。Ollama の行の RTF は、各回の作り終えるまでの時間をその回の音声の長さで割った値の中央値。llama.cpp の RTF は llama-tts が表示した処理時間の合計から出した値で、リクエストから受け取り終わりまでを測った Ollama の行とは測り方が違うので、速さを比べる値には使わない。
文字誤り率の平均は8.9〜16.1%に散らばったが、その開き (丸める前の値で約7.1ポイント) は同じ条件の2回の開き (約6.2ポイント) と大差なく、今回の測り方ではどれがより正確とは言えない。Ollama の行どうしでは、Q8_0・BF16 にすると size_vram の報告値が大きくなり、RTF の値も大きくなった (RTF は小さいほど速い)。まず動かしてみるなら、モデル本体がいちばん小さい既定の lfm3-omni:2b (Q4_K_M) から始められる。用途に足りる正確さかは、量子化によらず作った音声を聞いて確かめる。
GPUとCPUで、音声を作り終えるまでの時間
モデルを読み込んだ後なら、Core i7-14700F の CPU だけでも、日本語1文を、頭の無音を含む WAV 全体の長さの半分以下の時間で作り終えた (中央値)。
表「1文を作り終えるまでの時間」の RTF は、作り終えるまでの時間をその回の音声の長さで割った値で、1より小さければ再生より速く作れている。「声のデータが届き始めるまで」は、リクエストを送ってから、最初の音 (振幅の絶対値500以上) を含むデータを受け取るまでの時間を表す。「作り終えるまで」は WAV を最後まで受け取るまで、「音声の長さ」は頭の無音を含む WAV 全体の長さ。
| 条件 | 声のデータが届き始めるまで | 作り終えるまで | 音声の長さ | RTF |
|---|---|---|---|---|
| RTX 5080・日本語 | 0.087秒 | 0.387秒 | 5.28秒 | 0.074 |
| RTX 5060 Ti・日本語 | 0.126秒 | 0.574秒 | 4.96秒 | 0.109 |
| CPU だけ・日本語 | 0.532秒 | 2.405秒 | 5.12秒 | 0.470 |
| RTX 5080・英語 | 0.045秒 | 0.315秒 | 4.16秒 | 0.076 |
| RTX 5060 Ti・英語 | 0.063秒 | 0.487秒 | 4.08秒 | 0.117 |
| CPU だけ・英語 | 0.249秒 | 1.919秒 | 4.00秒 | 0.481 |
値はすべて中央値で、モデルを読み込んだ後の値 (慣らしの1回は除く)。RTX 5080 の行は、2回測ったうちの2回目 (声のデータが届き始めるまでの時間も記録した方) の値。条件は Ollama 0.40.13、lfm3-omni:2b (Q4_K_M)、日本語は10文×3回・英語は5文×3回で、同じ PC の中の通信、同時に1つのリクエストだけを送った。RTF は各回の比の中央値なので、表の時間どうしを割った値とは少し違う。CPU だけの行は Core i7-14700F で、Ollama からは GPU を見えなくして動かした。RTX 5060 Ti は OCuLink 接続。
CPU だけの日本語でも、RTF (分母は頭の無音を含む WAV 全体の長さ) は30件すべてで0.5未満だった。本番の前に入れた慣らしの1回目も、CPU だけの日本語で RTF 0.76 と1を下回った。この速さは Core i7-14700F でのもので、ほかの CPU での速さは測っていない。
WAV の頭に入る無音
返ってきた WAV の頭には無音が入り、長さは日本語で約0.5〜1.6秒、英語で約0.13〜0.32秒だった。ここでの無音は、振幅の絶対値が500 (16bit の値) に届くまでの区間を指す。声のデータそのものは、日本語では GPU で0.1秒前後、CPU だけで約0.5秒、英語では GPU で0.05秒前後、CPU だけで約0.25秒で届き始める。それでも WAV を頭から再生すると、声が聞こえるのは無音のぶん後になる。無音を削る方法は試していない。
自分の PC で速さの目安を見る
curl のマニュアルによると、手順の節の curl.exe のコマンドの末尾に -w "%{time_total}" を足すと、curl が受け取り終わるまでにかかった秒数を最後に表示する。その秒数が、保存した WAV を再生した長さより短ければ、その PC でも再生より速く作れている目安になる。表「足す指定」は、その指定の意味をまとめたもの。
| 指定 | 意味 |
|---|---|
-w "%{time_total}" |
受け取り終わるまでにかかった秒数 (time_total) を最後に表示する |
-w "%%{time_total}" |
バッチファイル (.bat) に書くときの形。% を2つ重ねる (everything.curl.dev の write-out の説明による) |
モデルを読み込んだ直後の1回目は遅くなることがあるので、2回目以降で見る。-w を足した形は手元では打っていない。HTTP 400 などのエラーが返ったときも、curl は返ってきた中身を --output のファイルに保存するので、秒数を見る前に、保存したファイルが再生できる WAV かを確かめる (curl のマニュアルによると、--fail を足せば、400 以上のエラーでは中身を出さずに失敗として終わる)。
また、表「1文を作り終えるまでの時間」の値は curl ではなく、別の計測用のスクリプトで取ったものだ。このスクリプトは、PC の中で接続を済ませてからリクエストを送り始め、WAV を受け取り終えるまでを測った (ファイルへの保存は含まない)。curl の time_total は接続を含む操作全体の時間なので、表の値と同じになるかを確かめるためのものではなく、その PC での目安として使う。
Ollama のドキュメントによると、返ってくる WAV はヘッダーのサイズの欄が最大値になっている。再生ソフトで長さが正しく表示されないときは、-w "%{time_total} %{size_download}" として受け取ったバイト数も表示させ、(バイト数 − 44) ÷ 48,000 で秒数を出せる (24kHz・16bit・モノラルなので1秒は48,000バイト。今回受け取った Ollama 0.40.13 の WAV は、先頭の44バイトがヘッダーだった。ほかのバージョンでも同じかは確かめていない)。再生ソフトでの長さの表示は試していない。
メモリの使用量
lfm3-omni:2b (Q4_K_M) で日本語30件を読ませる測定を終えた後、画面出力に使っていない GPU (RTX 5060 Ti) では、nvidia-smi で見た GPU 全体の使用量が3,052MiB (約3.0GiB) だった。CPU だけの測定では、30件を読ませた直後に見た llama-server.exe だけの作業セットが約2.1GiB だった (PC 全体の使用量ではない)。どちらの値も、生成中のいちばん多いときの量や、動かすのに要る最低限の量ではない。表「測定前と測定後のメモリ」は、その2つの値を並べたもの。
| 条件 | 測定前 | 日本語30件の測定を終えた後 |
|---|---|---|
| RTX 5060 Ti (nvidia-smi の GPU 全体の使用量) | 0MiB | 3,052MiB |
| CPU だけ (llama-server.exe の作業セット) | — | 約2.1GiB |
CPU の行は、Ollama が起動した llama-server.exe のメモリ (作業セット) を、日本語の読み上げ30件の直後に見た値。GPU の行は、測定を始める前と30件を終えた後に nvidia-smi で見た GPU 全体の使用量で、モデルの重みだけの量ではない。
Ollama が報告した量 (/api/ps の size_vram) は、Q4_K_M で1.38GB (1.29GiB)、Q8_0 で2.13GB (1.98GiB)、BF16 で3.75GB (3.49GiB) だった。この値は、nvidia-smi で見た使用量とも、Ollama のログに載った各領域の合計とも一致しなかった。画像・音声を扱う部分 (projector) などがこの報告値にどこまで入っているかは確かめていないので、この値から動かすのに要る VRAM の量は見積もらない。表「量子化と動かすソフトごとの結果」の「Ollama の報告値 (size_vram)」はこの値。
RTX 5080 で読み込んだときの Ollama のログでは、Q4_K_M のとき、モデル本体・画像と音声を扱う部分・作業用の領域を合わせて約2.8GiB を GPU に置いていた。RTX 5060 Ti の nvidia-smi の使用量が測定前の0MiBから測定後に3,052MiBになったこと (Ollama が報告した size_vram は2枚で同じ値だった) と合わせると、実際に GPU で使われた量は報告値よりこちらに近い。表「量子化と動かすソフトごとの結果」の報告値は、Q8_0・BF16 と大きくなるほど増えた。
これより VRAM やメモリの少ない PC で動くかは測っていない。
文字で会話させたときの速さと日本語
同じモデルにチャットで日本語の質問をすると、CPU だけでも返答を生成する速さの中央値は47.3トークン/秒だった。GPU では RTX 5080 で434.7トークン/秒、RTX 5060 Ti で265.5トークン/秒になった。質問は、遅刻を上司に伝える短いメール・日本の首都を一文で・雨の日に家で楽しめることを三つ、の3つで、それぞれ3回ずつ聞いた。表「返答を生成する速さ」は、その9回の中央値を装置ごとに並べたもの。
| 装置 | 返答を生成する速さ (中央値) |
|---|---|
| RTX 5080 | 434.7トークン/秒 (412.7〜443.0) |
| RTX 5060 Ti | 265.5トークン/秒 (234.5〜271.7) |
| CPU だけ | 47.3トークン/秒 (46.9〜54.1) |
括弧の中は9回の最小と最大。条件は Ollama の /api/chat、temperature 0、num_predict 256。速さは Ollama が返す eval_count を eval_duration で割った値で (eval_duration はナノ秒で返るので秒に直した)、入力の処理は含まない。返答の長さは8〜103トークンで、どれも上限の256トークンに届かない短い返答だった。この速さは短い返答で測ったもので、長い返答での速さは測っていない。
返答は日本語の文として読めた。首都を聞くと「日本の首都は東京です。」と返し、雨の日の過ごし方は箇条書きで3つ挙げた。上司への遅刻の連絡メールでは、これから遅れることを伝える文面に「事前にご連絡いたしました」と過去形の文が混じった。質問は3つだけで、知識や文章の質を広く評価したものではない。
返答を声にするなら、文字の返答を /v1/audio/speech に渡すので、チャットの待ちに読み上げの時間が加わる。2つをつないだときの合計の時間は測っていない。
測定の環境と条件
表「測定機とソフト」は、測定に使った機材とソフトのバージョンを並べたもの。
| 項目 | 内容 |
|---|---|
| OS | Windows 11 |
| CPU | Core i7-14700F |
| メインメモリ | 96GB |
| GPU | RTX 5080 (VRAM 16GB)、RTX 5060 Ti (VRAM 16GB、OCuLink で外付け) |
| NVIDIA ドライバ | 610.88 |
| Ollama | 0.40.13 |
| llama.cpp (量子化の比較の1行だけ) | b11979 の llama-tts |
| 文字起こし | faster-whisper 1.2.1 の large-v3-turbo (CUDA、compute_type=float16、beam_size=5。言語は日本語に ja、英語に en を指定) |
GPU ごとに Ollama を別々に起動し、1つの GPU だけを見せて測った。CPU だけの測定では、Ollama から GPU を見えなくして動かした。RTX 5060 Ti は OCuLink 接続なので、内蔵の PCIe x16 接続で同じ値になるかは確かめていない。Ollama は装置ごと (RTX 5080・RTX 5060 Ti・CPU だけの3つ) にポート番号を分けて起動し、モデルをメモリに置く時間 (OLLAMA_KEEP_ALIVE) は30分、同時に載せるモデルの数 (OLLAMA_MAX_LOADED_MODELS) は1にして、Vulkan は使わない設定にした。ほかの設定は既定のままで、ログ上のコンテキスト長は4,096、CPU だけの測定のスレッド数は Ollama の自動設定の14だった。読み上げのリクエストで送ったのは model・input・voice・response_format の4つだけで、声の揺らぎに関わる設定 (サンプリングの値や seed) は指定しておらず、実際に使われた値も記録していない。
読ませた文は日本語10文と英語5文で、1文ずつ3回読ませ、本番の前に1回の慣らしを入れた。慣らしの回は集計に入れていない。この記事でいう「1文」は1回のリクエストで送った入力のことで、日本語の1・3と英語の1は2つの文を含む。表「読ませた日本語の文」は、日本語の10文を並べたもの。
| 番号 | 文 |
|---|---|
| 1 | こんにちは。今日はとても良い天気なので、散歩に行きましょう。 |
| 2 | 明日の会議は、午後から本社で始まります。 |
| 3 | ありがとうございます。助かりました。 |
| 4 | ご注文の商品は、本日発送いたしました。 |
| 5 | 駅の改札を出て、左に曲がるとすぐにコンビニがあります。 |
| 6 | パソコンの電源を入れても、画面が真っ暗なままです。 |
| 7 | 申し訳ございませんが、その日はすでに予約で埋まっております。 |
| 8 | 電車が遅れているので、少し遅れて到着します。 |
| 9 | この料理は、野菜をたっぷり使っていて体に優しい味です。 |
| 10 | 週末は家族と一緒に、海辺の小さな町へ旅行する予定です。 |
表「読ませた英語の文」は、英語の5文を並べたもの。
| 番号 | 文 |
|---|---|
| 1 | Hello. The weather is really nice today, so let us go for a walk. |
| 2 | Your order has been shipped and should arrive within a few days. |
| 3 | Please restart the computer and check whether the screen turns on. |
| 4 | The meeting tomorrow will start in the afternoon at the main office. |
| 5 | Thank you very much for your help with the project last week. |
表の数字の取り方を補うと、表「装置ごとの文字誤り率」の平均と中央値は30件それぞれの文字誤り率から出した値で (平均は30件の値の単純な平均で、全部の文字をまとめて割った誤り率ではない)、「文字起こしが一致した回 (正規化の後)」は、正規化した文字起こしが元の文と1文字も食い違わなかった件数。比べる前に除いたのは、空白と 、。,.,.!?!?「」『』()()…—-–’'" の各文字。表「1文を作り終えるまでの時間」は日本語30件・英語15件の中央値、表「返答を生成する速さ」は9回の中央値。
本記事の実測値は2026年10月30日に、上記の測定機・設定で計測したもの。
今回確かめていないこと
- Mac (Apple シリコン) や Linux での動作
- Core i7-14700F 以外の CPU や、VRAM の少ない GPU での速さ
- 音声の入力 (聞き取り)
- 音声で答える使い方 (
/api/chat以外で音声で返させる方法) - 聞いた印象での自然さ
- 長い文章や長い返答
- 男性の声 (
male-japanese) - 複数のリクエストを同時に送る使い方
- WAV の頭の無音を削る方法
- 既定の設定の PowerShell で、日本語をコマンドに直接書いた場合
- エディタやコマンドごとの JSON ファイルの保存の仕方 (BOM 付き UTF-8 以外の、UTF-16 や ANSI で保存したファイルを送った結果)
- モデルの読み込みにかかる時間
- チャットと読み上げをつないだときの合計の時間
- 音声のサンプリングの設定 (実際に使われた値と、モデルカードが推奨する audio_temperature=0.4 などに変えた場合)
- 消費電力
まとめ
- 日本語は音声にできたが、自動の文字起こしで読み戻すと30件の多くでどこかが食い違い、別の語への置き換わりや、2つの文の入力で片方の文が出てこない例があった (音声と文字起こしのどちらの誤りかは切り分けていない)。GPU と CPU だけの違いは見えなかった。読み違いが困る用途では、作った音声を聞いて確かめてから使う。
- 日本語1文 (約5秒の音声) なら、モデルを読み込んだ後は Core i7-14700F の CPU だけでも RTF が1を下回り、再生より速く作れた。ただし WAV の頭の無音のぶん、声が聞こえるまでは待ちが加わる。自分の PC で目安を見るには、curl.exe に
-w "%{time_total}"を足して出した秒数と、保存した WAV の再生の長さを比べる (この形は手元では打っていない)。 - Windows では、日本語は UTF-8 (BOM なし) で保存した JSON ファイルを
--data-binaryで送る。測定機の Git Bash で curl の-dに直接書くと文字起こしが元の文とまったく別の言葉になり、Git Bash の curl から BOM 付きのファイルを送ると受け付けられなかった。
参考資料
- LiquidAI/LFM3-Omni-2B (Hugging Face)
- LiquidAI/LFM3-Omni-2B LICENSE (Hugging Face)
- lfm3-omni (Ollama)
- Ollama v0.40.13 リリース (GitHub)
- Speech (Ollama ドキュメント)
- Ollama v0.40.13 model/renderers/lfm3_speech.go (GitHub)
- llama.cpp b11979 リリース (GitHub)
- SYSTRAN/faster-whisper (GitHub)
- curl のマニュアル (curl.se)
- Write out (Everything curl)
- lfm3-omni のタグ一覧 (Ollama)
- about_Character_Encoding (Microsoft Learn、PowerShell 5.1)